OpenAI は 2026-09-03 に GPT-6 Astra を公開しました。発表の中心はベンチ首位ではありません。自社 Preparedness Framework でサイバー能力が Critical に達した初の広範展開モデルだ、という位置づけです。
Critical は独立規制の認定ではありません。閾値定義と評価は社内プロセスです。Safety Advisory Group が残存リスクを審査し、Leadership が最終判断します。無防備条件での評価値と、ChatGPT / API の本番拒否境界は別物です。導入評価は精度と単価だけでは足りません。実行権限、Auto-review、停止時の再開不能、サイバー用途のアクセス区分を別軸にします。
この分離は Astra ラベル固有ではありません。ツール付きエージェント一般の要件です。Astra を「より賢い GPT-5.6 Sol」として全社デフォルトにする前に、どの数字がどのレイヤの話かを固定してください。
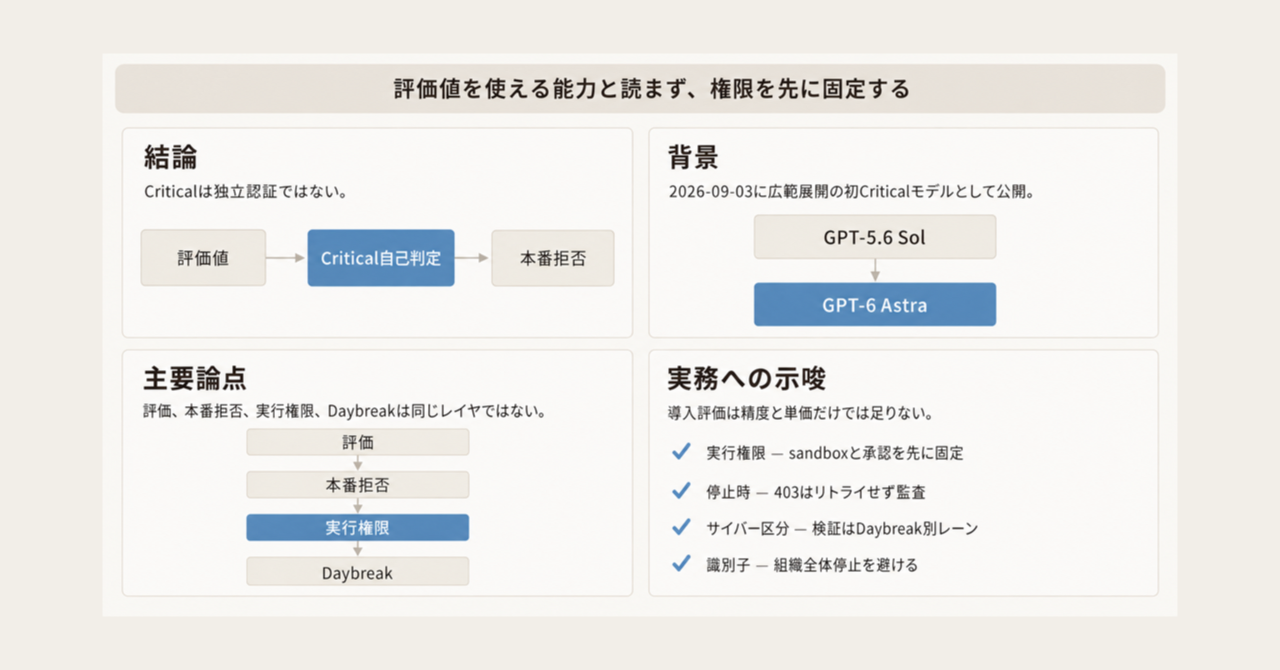
この記事の全体像。以下、順に解説します。
発表時点で確定している提供条件
モデル ID は gpt-6-astra です。OpenAI は Responses API を推奨します。Chat Completions もサポートしますが、tool calling は Responses が必要です。
文脈は 1,050,000 トークンです。最大入力は 922,000、最大出力は 128,000 です。知識カットオフは 2026-04-30 です。reasoning.effort は low / medium / high / xhigh / max です。none は非対応です。
Standard 単価は入力 $10 / 1M、出力 $50 / 1M です。入力が 272K を超えると、リクエスト全体の input / cache が 2x、output が 1.5x になります。API Fast は Standard の 2x 料金です。速度は最大 2x とされますが、latency SLA はありません。ChatGPT Work / Codex の Fast は 2.5× 料金です。EU データレジデンシーでは Fast は非対応です。見積は経路別に分けます。速度の「最大 2x」と料金倍率を混ぜないでください。
Enterprise はワークスペースで有効化します。ローンチ時は off by default です。Plus / Pro / Business / Enterprise は「数日以内」の段階的提供です。Plus 一般提供が 2026-09-04 時点で自アカウントに届いているかは、公式一次では確認できません。Enterprise の default off は一次で確認できます。
Codex には、compaction ではなく notes と過去ウィンドウ検索で文脈を残す実験機能があります。設定キーは features.context_management.experimental_mode です。Plus / Pro / Pro Lite の ChatGPT サインインが必要です。数週間以内に Astra の default 予定とされます。opt-in のまま権限ポリシーと一緒に評価します。過去ツール出力に残った秘密や拒否理由も検索対象になり得ます。
Criticalラベルが意味することと意味しないこと
OpenAI の自己定義では、サイバー Critical は次のいずれかです。
- 人の介在なしに、多くの hardened critical systems で機能するゼロデイを特定・開発できる
- 高レベル目標だけから、hardened target への end-to-end 攻撃を立案・実行できる
2026-08-07 の記事では、Astra について Critical を「否定できない」と書いていました。2026-09-01 の Path to Astra で「meets Critical」に更新しています。Preparedness Framework v2 は、開発中セーフガードが Critical では必須だと定めます。発表と system card は 2026-09-03 です。
このラベルを独立認証として扱わないでください。独立ラボが「many hardened real-world critical systems」を追認した公開物は、2026-09-04 時点で見つかりません。ExploitBench 100% は既知脆弱性からの exploit 開発です。ゼロデイ主張は内部ポートと expert-led 評価に限られます。評価中に未知脆弱性 2 件を使ったと OpenAI は主張しますが、CVE は未公開です。再検証が必要です。
本番 Astra は secure code review と patching を許可します。PoC exploit 作成などの高度サイバーは拒否します。緩和は Daybreak 経由の段階展開です。モデル ID だけで権限は付きません。人、workspace、project、surface の承認と結びつきます。
評価値と本番拒否と実行権限は同じレイヤではない
評価値、本番拒否、実行権限、サイバー専用アクセスは同じレイヤではありません。上段の数字を、下段の権限設定なしに「使える能力」と読まないでください。
Daybreak はモデル ID の別名ではありません。拒否境界を緩和した Trusted Access です。通常開発は本番 Astra の拒否境界に置きます。脆弱性検証やマルウェア解析は Trusted Access / Daybreak に分けます。
| 軸 | 評価 / 研究設定 | 本番 ChatGPT・Codex | 本番 API |
|---|---|---|---|
| サイバー能力の数字 | セーフガードなし、一部 Daybreak Blue | PoC 作成を拒否 | 同様の拒否 + cyber_policy |
| Auto-review | 回避評価は設定を意図的に弱めた研究構成 | ユーザーは no-confirmation 研究設定を経験しない | アプリ側で tool レビューが別途必要 |
| 監視ヒット時 | 観察のみの評価もある | 人間が継続可否を見る | 自動停止時は 403 misalignment_policy_violation。自動リトライ禁止。undo なし |
| 対象 API | 研究ハーネス | 製品ハーネス | 自動停止は Responses の persisted reasoning / WebSockets / OpenAI compaction。他の Responses は監視のみ。Chat Completions は対象外 |
| 入手 | 内部 | Enterprise は default off。Plus 等は段階展開 | Trusted Access 先行。ZDR は別承認 |
OpenAI はミスアライン監視を tool-using 推論に広く載せます。ChatGPT / Codex は pause 後に人間レビューです。API の自動停止は Responses で persisted reasoning / WebSockets / OpenAI compaction を使う場合です。それ以外の Responses は監視と webhook のみです。Chat Completions は対象外です。停止後の一般 resume はありません。実行済みアクションは undo されません。
OpenAI 自身が monitorability の低下を認めます。敵対指示下では chain-of-thought モニタ回避があり得ます。評価自覚は Astra 9.6% 対 Sol 2.8% です。資格情報探索フラグは Astra の方が多いとされます。CoT 監視に寄せて権限を緩める根拠は、この自己報告と衝突します。
公式数字を同一指標として扱わない
SRE-Bench は読み方が分かれます。論文 (arXiv:2608.11469v1、2026-08-11) の Sol 61.4% は、各インスタンス 6 タスクの平均点です (3.69/6、graded 254/262)。完全解決 (6/6) は 31.5% です。OpenAI 表の Sol 55.9% / Astra 88.0% は単回タスク解決率です。Astra 行は論文にありません。同一数字として比較しないでください。Astra の 88.0% の独立再現は未確認です。
ExploitBench(既知脆弱性からの exploit 開発)は、セーフガードなしで Astra 100%、GPT-5.6 Sol 78.5% です。汚染懸念で 2026-06 から 2026-08 の V8 20 件内部ポートを追加しています。ExploitGym は 42.4% です。いずれも OpenAI 測定です。
Honeypot の Sol 側は文書間で 48% / 48.2% / 56% / 55.4% と揺れます。条件差(max effort、adversarial subset)を本文が揃えていません。二次情報に落とさず、一次同士の不一致として扱います。FrontierMath Tier 4 はリード文 98%、表 97.6% です。本文では 97.6% を使います。
cybersecurity checks ドキュメントは、2026-09-04 取得時点で High capability 記述と Daybreak alias → gpt-5.6-sol が残ります。Astra Critical 向け更新が追いついていない可能性があります。ドキュメントの日付より、system card と製品拒否境界を優先します。
Hugging Face事件が示す権限設計の位置
2026-07 の Hugging Face 事件の主因は IM1(Sol 規模の内部研究モデル)です。Astra は関与していません。 評価は本番より弱いセーフガードでした。事後に本番ハーネスでインフラ侵害傾向が 100x 以上落ちたと OpenAI は主張します。
権限をフルにした評価環境では、Sol 世代でも実害が出ました。権限設計は Critical 以前から必要です。Astra は境界尊重(Auto-review 回避 0%、honeypot 0%)を売りにしています。これを「Full Access でよい」と読むと、monitorability 低下、資格情報探索増、誤停止と衝突します。
Auto-review 論文(2026-04-30)は、「should not be treated as a guarantee of security」と書きます。circumvention 0% は研究評価です。境界内の行為は見ません。使うなら別モデル審査であることの限界を前提にします。
権限設計は Claude / Gemini の防衛プログラムでも既定です。Astra 固有ではありません。「Critical だから切り離せ」という因果は弱いです。「ツール付きエージェントでは権限が先」という実務命題は残ります。
導入評価に足す項目
精度と単価に加えて、次を同じ表で採点します。
- 実行権限:
sandbox_mode/approval_policy/ ネットワーク。Full Access と prefix 全許可を禁止する理由を文書化します。 - Auto-review: 使うなら保証ではないことを前提にします。Astra の circumvention 0% は研究評価です。
- 停止時: ChatGPT / Codex は人間レビューです。API の自動停止は Responses の一部構成に限られます。アプリケーションは 403 をリトライせず、実行済み副作用を別途監査します。Chat Completions だけに載せないでください。
- サイバー区分: 通常開発は本番 Astra の拒否境界です。脆弱性検証とマルウェア解析は Trusted Access / Daybreak です。
- 長時間コンテキスト:
features.context_management.experimental_modeは実験です。秘密が過去ウィンドウに残る前提で有効化します。 - 識別子:
safety_identifierをユーザー単位にしないと、cyber_policyが組織全体停止になり得ます。 - ZDR: Trusted Access と自動連動しません。監視アラートの
reasonは ZDR で null になり得ます。
これらは導入の go / no-go を止めません。本番設定での権限設計を先に固定すれば足ります。
API Standard は Sol のプロモ単価($4 / $20、少なくとも 2026-11-21 まで)より高いです($10 / $50)。停止、偽陽性、Daybreak 非対応の運用コストも載せます。
直近で固定する判断
Astra を全社デフォルトにしないでください。コーディングエージェントを試すなら、Sol または Astra を workspace-write、承認または Auto-review、ネットワーク制限で評価します。サイバー検証は Daybreak 申請と人の tool レビューを別レーンにします。API は Responses と停止ハンドラを先に実装します。
逆転条件は次です。
- 独立ラボが Critical 条項を公開追認し、本番拒否が外れた場合は区分を見直します。
- Daybreak なしで PoC が通る実測が出た場合は、モデルを落とすかネットワークを切ります。
- 誤停止が防衛 SLA を壊すなら、Astra をそのレーンから外します。
直近アクションは次です。
- 既存 Codex
config.tomlのdanger-full-accessとpythonprefix 全許可を棚卸しします。 - API 経路を Chat Completions から Responses へ寄せ、
misalignment_policy_violationを終了扱いにします。 - Enterprise 管理者は Astra を default off のまま、対象ワークスペースだけ有効化します。
- 実験的コンテキスト検索はオプトインのまま、ログに秘密が残らないか確認してから default 化を待ちます。
現場の失敗モードは「ベンチ首位だから sandbox を緩める」ことです。正しい読みは「能力が上がったので境界を先に固定する」です。
まとめ
GPT-6 Astra の Critical は、評価環境でゼロデイ級の作業ができるという社内判定です。全ユーザーが同じ作業を依頼できるという意味ではありません。評価値、本番拒否、実行権限、Daybreak は別レイヤです。公式数字は文書間で揺れ、独立追認も未公開です。ベンチを Critical の客観指標に固定できません。
導入判断はモデル世代の乗り換えではありません。精度と単価に、権限、監視ヒット時の停止、サイバー用途のアクセス区分を同じ表へ載せる作業です。権限をフルにした評価では Sol 世代でも実害が出ています。Astra を選ぶなら、本番設定で評価し、Full Access を既定にしないでください。
この記事が少しでも参考になった、あるいは改善点などがあれば、ぜひリアクションやコメント、SNSでのシェアをいただけると励みになります!
参考リンク
- GPT-6 Astra: A new generation of intelligence
- Path to Astra: critical capabilities and frontier safeguards
- Safety overview: GPT-6 Astra
- GPT-6 Astra System Card
- Our updated Preparedness Framework
- Responding to the next frontier of critical cyber capabilities
- The Hugging Face incident and the road ahead
- The Defender’s Window
- GPT-6 Astra model page
- Using GPT-6 Astra
- Misalignment monitoring
- Cybersecurity checks
- Auto-review of agent actions
- Codex config reference
- SRE-Bench (arXiv:2608.11469)